







Denk even terug aan je schooltijd. Een examen met open vragen, en dan stuit je op een vraag waarvan je het antwoord niet weet. Wat doe je?
Je vult iets in, vanzelfsprekend. Een leeg antwoord is gegarandeerd fout, terwijl een halve pagina over ongeveer het juiste onderwerp nog altijd een punt kan opleveren. Dus gebruik je de juiste vaktermen, klink je overtuigd, en vermijd je zorgvuldig alles wat specifiek genoeg is om fout gerekend te worden. Dat is ook een vrij precieze beschrijving van een hallucinerende chatbot. En dat is geen toeval. In het onderzoek Why Language Models Hallucinate (2025) zegt OpenAI dat modellen worden getraind en beoordeeld op tests waarbij een fout antwoord en een "ik weet het niet" precies evenveel opleveren: niets. Onder die spelregels is gokken simpelweg de betere strategie. Dus dat doet het ai model ook: gewoon gokken.
Niet omdat het stuk is, maar omdat het heeft geleerd wat wij het hebben aangeleerd: dat zelfverzekerd klinken loont.
De lat ligt bij een collega, niet bij een examenkandidaat
Als je iemand aanneemt, zoek je geen goede kandidaat. Je zoekt de collega die zegt: "ik weet het eerlijk gezegd niet zeker, maar Marijke van HR gaat hierover." Of beter nog: "dat staat in het beleidsdocument van 2024,onderaan het document. Ik zoek de link even voor je op."Die collega is waardevoller dan degene die een antwoord verzint. En juist dáárom kun je vertrouwen op de antwoorden die diegene wél geeft. Bijna geen enkele chatbot is op die lat gebouwd. En dat kost meer dan je denkt.
Wat het kost
De chatbot van Air Canada verzon een terugbetalingsregeling. Een klant vertrouwde erop, de luchtvaartmaatschappij weigerde de regeling na te komen, en een geschillencommissie stelde Air Canada aansprakelijk: het maakt niet uit of verkeerde informatie van een webpagina komt of van een bot. Air Canada zei dat de chatbot een aparte juridische entiteit was, verantwoordelijk voor zijn eigen daden. Daar ging de commissie niet in mee.
De bot zit vaak genoeg mis dat mensen hem niet meer vertrouwen. Dus controleren ze de antwoorden alsnog bij de bron, precies het werk dat de bot uit handen moest nemen. Tickets die hij had moeten afvangen, komen een week later gewoon terug. Nu met de openingszin: "jullie chatbot zei dat…". Niemand meldt een bug, want er is niet echt iets stuk. Hij wordt elke maand een beetje minder gebruikt....
Eerst het ongemakkelijke deel: je data
De meeste kwaliteitsproblemen bij chatbots zijn contentproblemen. Bestaat je kennisbank bijvoorbeeld uit een map met pdf's die voor het laatst in 2023 zijn bijgewerkt, drie tegenstrijdige versies van hetzelfde beleid en een wiki waar niemand meer aan heeft gezeten sinds de schrijver vertrok? Dan redt slimme engineering je ook niet meer.
Die expert-collega is namelijk nooit beter dan het materiaal waarop hij zich heeft ingelezen. Geef hem de aantekeningen van vorig jaar en hij legt je vol overtuiging de regels van vorig jaar uit.
Dit is de minst leuke bevinding én de meest voorkomende. Bovendien is het zelden binnen hetzelfde kwartaal op te lossen, want content opschonen is een groot project waar mensen bij betrokken zijn die niets met jouw chatbot hebben.
De bruikbare vraag is dus niet: hoe krijgen we eerst de data op orde? Maar: hoe bouwen we iets dat gecontroleerd faalt op gebrekkige data, en hoe komen we erachter hoe slecht het er nu voorstaat?
Begin bij de mechanische helft, dat is een stuk eenvoudiger. Vraag je af wat er gebeurt als iemand een pdf in je systeem gooit. Het antwoord is vaak: niets. Of erger dan niets, het bestand wordt geaccepteerd, er komt geen tekst uit, en de bot beantwoordt vrolijk vragen over een document waarvan hij geen woord heeft gezien.
Gescande papieren zijn het klassieke geval. Een pdf die uit Word komt, heeft een tekstlaag die je kunt uitlezen. Een pdf die van een scanner rolt, is een stapel foto's van papier. In een bestandsbeheerder zien ze er identiek uit, en gedragen ze zich totaal verschillend.
Scan dus alles in, en wees duidelijk over wat je níet hebt kunnen lezen. Pak de tekstlaag waar die er is: pdf, Word, PowerPoint, Excel, HTML. Zet alleen een model in om de paginabeelden te lezen waar géén tekstlaag zit, en label die bron dan ook als zodanig. Want een model dat je vraagt een pagina te lezen, levert een weergave op die er betrouwbaar uitziet. En dat is precies het soort bron waar je achteraf geen citaat meer aan kunt toetsen.
Rapporteer bovendien per bestand, niet per batch. Iemand sleept elf documenten naar binnen, één daarvan is een .doc uit 2004, en die andere tien moeten alsnog landen.
Boeiend werk is het niet. Maar een verrassend groot deel van alle "de bot weet niets over X" blijkt X te zijn, netjes opgeslagen in een bestand dat in stilte niets heeft opgeleverd.
Leer hem "ik weet het niet" zeggen
Wil je een bot die onzekerheid toegeeft? Dan moet er iets zijn dat dat toegeven beloont. Dat is de les van het examen, toegepast: reken een fout antwoord zwaarder aan dan een leeg antwoord, en "ik weet het niet zeker, maar hier is het beleidsdocument" wordt ineens de winnende zet in plaats van de verliezende.
Ontwerp vervolgens het weigeren zelf goed, want daar gaat het meestal mis. Een bot die alleen maar "daar kan ik je niet mee helpen" zegt, is erger dan nutteloos: gebruikers leren hun vraag net zo lang te herformuleren tot ze hem alsnog aan het praten krijgen. En dan heb je een bot die op commando bluft.
Een bot die zegt: "dat staat niet in mijn bronnen, maar het personeelshandboek behandelt het wél, en Support kan het voor je bevestigen". Die is eerlijk en meteen ook echt bruikbaar. Goed doorverwijzen is een feature, geen nederlaag.
Laat hem zien wáár het staat
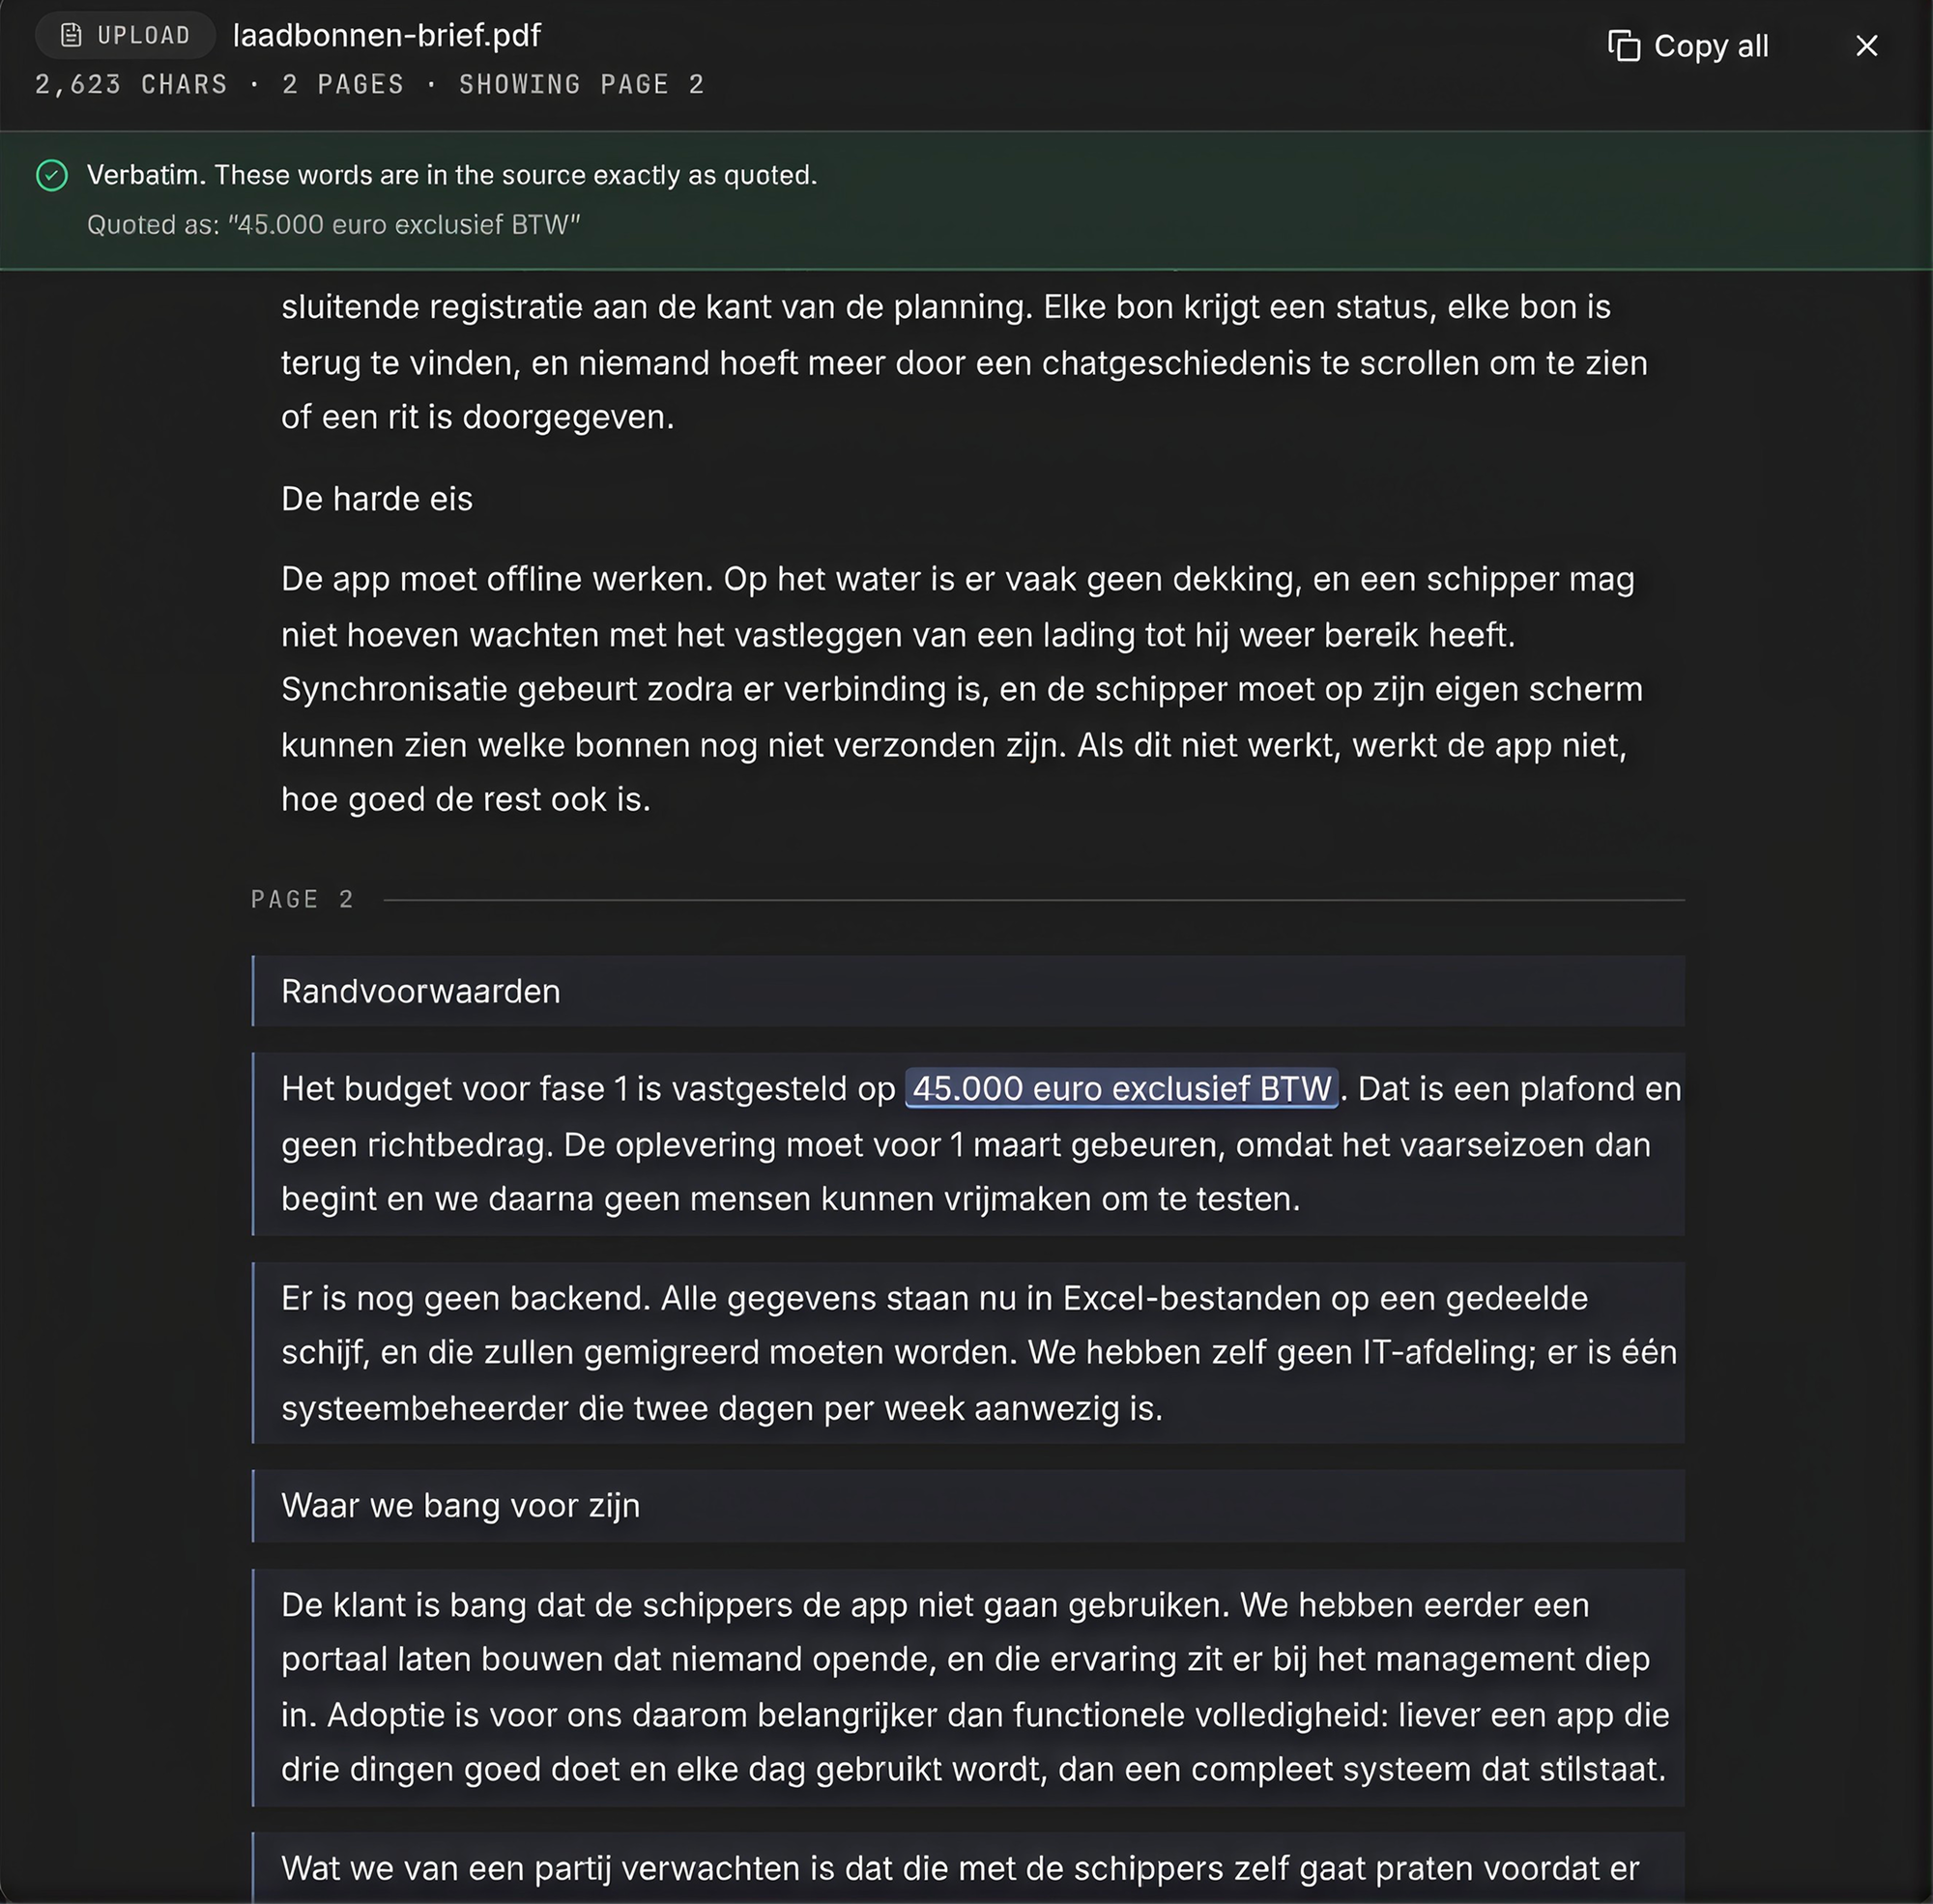
De meeste chatbots doen hier een symbolische versie van: een lijstje documenten onder het antwoord. Dat is een bronnenlijst, geen bronvermelding. Het vertelt je welke boeken op tafel lagen, niet welke zin er gelezen is. Zo'n lijstje is bovendien moeiteloos te produceren terwijl de bewering er alsnog bij verzonnen wordt, want die lijst komt uit de zoekindex en niet uit het antwoord. De versie die je wél wilt, werkt anders. Knip het materiaal op in genummerde passages en eis dat elke bewering twee dingen meedraagt: de passage waar hij vandaan komt en de exacte woorden. En dan is dit het deel dat het product echt verandert zoek je die woorden op in het opgeslagen document, nádat het antwoord is geschreven.
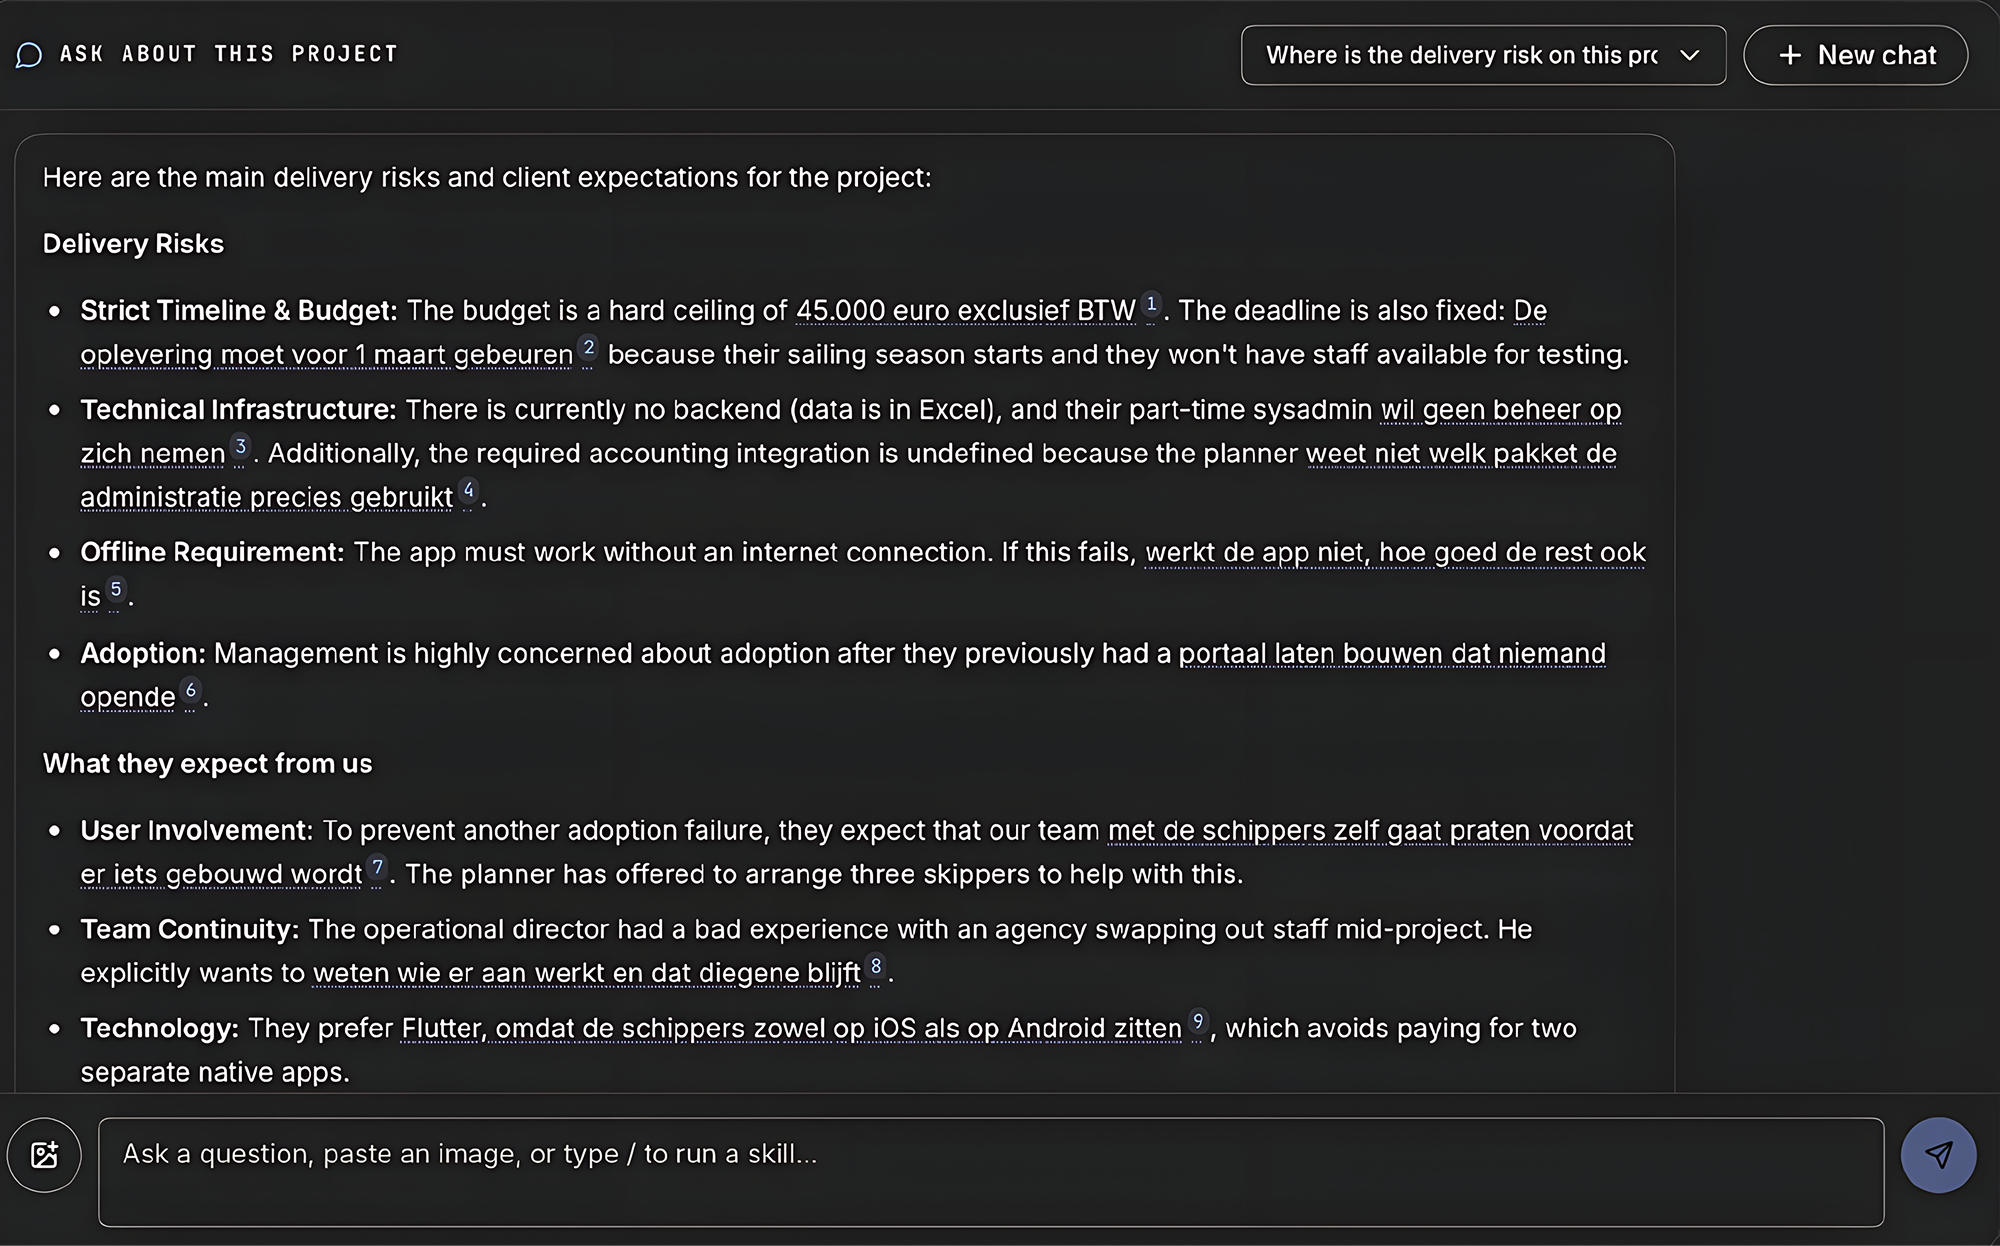
Er zijn maar vier mogelijke uitkomsten, en alle vier zijn ze het waard om aan de lezer te laten zien. De woorden staan in de bron, teken voor teken. De opening staat er wel, en het model heeft de rest ingekort. De passage bestaat, maar die woorden staan er niet in. Of de passage heeft nooit bestaan.
Die laatste is waar het allemaal om draait. Vóór de controle zien "volgens de onderzoeksnotities" en een volledig verzonnen set onderzoeksnotities er op het scherm precies hetzelfde uit. Daarna niet meer. En dan ziet iedereen in één oogopslag welke zinnen in een antwoord dragend zijn. Het citaat moet ook meteen de link zijn. Klik erop en je landt in het document op precies die plek, gemarkeerd, met de tekst eromheen leesbaar. Want de vraag die je eigenlijk beantwoord wilt zien, is of het citaat in context nog steeds hetzelfde betekent.
De helft die nooit in de demo zit
Alles hierboven gaat over het antwoord. Maar of een chatbot zijn eerste jaar overleeft, hangt in deprimerend hoge mate af van alles eromheen.
Een expert-collega corrigeer je zonder code deploy, en zo hoort jouw chatbot ook te werken. Is er voor het aanpassen van een prompt, het toevoegen van een document of het corrigeren van een fout antwoord telkens een engineer en een release nodig? Dan verrot de content vanzelf, want de mensen die de content kennen, zijn niet de mensen met deploy-rechten.
Je moet ook kunnen zien wat hij doet. Tokens, latency en kosten per klant, inzichtelijk zonder dat je er een engineer voor hoeft te vragen: dát is wat "hij voelt de laatste tijd traag" verandert in een getal, en "moeten we dit nog wel aan laten staan" in een beslissing.
En de twee goedkoopste winstpunten in hoe goed het aanvoelt, hebben niets met juistheid te maken. Stream het antwoord, zodat de eerste woorden er meteen zijn in plaats van de hele alinea na vier seconden. En bied twee of drie vervolgvragen aan, want de meeste mensen hebben geen idee wat de bot eigenlijk allemaal kan.
Verander het examen
We hebben chatbots gekregen die zelfverzekerd de mist in gaan, omdat de tests waarop we ze afrekenen precies dat belonen: zelfverzekerd ongelijk. Wil je een expert in plaats van een geoefende bluffer? Dan moet je de beoordeling bouwen die dat beloont: correct als hij het weet, stil als hij het niet weet, en behulpzaam over waar je dán wél moet kijken.
Het is het goedkoopste punt op de lijst, en het enige dat rente op rente oplevert.
Vijf vragen die het stellen waard zijn
Je hoeft niet technisch te zijn om erachter te komen hoe een chatbot ervoor staat. Vraag het hem direct, of vraag het degene die je er een probeert te verkopen.
- Wat zegt hij als hij het niet weet? Stel een vraag die net buiten zijn materiaal valt. Vloeiend en zelfverzekerd is een onvoldoende.
- Waar komt dat vandaan? Probeer van een bewering naar de zin erachter te komen. Een bestandsnaam telt niet.
- Wat is er met de gescande documenten gebeurd? Netjes ingelezen, in stilte overgeslagen, of door een model gelezen en ook als zodanig gelabeld?
- Wie corrigeert een fout antwoord, en hoe snel? Is daar een engineer en een release voor nodig, dan verrot de content de mensen die de content kennen, zijn niet de mensen met deploy-rechten.
- Wat is het getal? Wordt kwaliteit niet gemeten, dan is elke discussie erover een kwestie van smaak. Ook die over budget.
Dat is een middagje werk op een systeem dat je al hebt. Het ongemakkelijke is dat de antwoorden meestal consistent zijn: een bot die zakt voor de eerste vraag, zakt doorgaans ook voor de rest. Het is namelijk allemaal dezelfde discipline, van verschillende kanten bekeken.
Wij bouwen en onderhouden chatbots en AI-features in productie, meestal voor opdrachtgevers die ze werkend moeten hebben op echte data en met echte gebruikers. Zit je ergens op dit pad, of loop je vast op het dataprobleem? We denken graag met je mee.